Kolika jazyky hovoří umělá inteligence?
Kolik řečí umíš, tolikrát jsi člověkem. Platí podobné přísloví i pro umělou inteligenci? Ve světě lidé hovoří zhruba 7000 jazyky[1]. Podle studie ČSÚ z roku 2022 zná 78 % Čechů v produktivním věku alespoň jeden cizí jazyk, 33 % alespoň dva a pouze 7 % umí tři a více cizích jazyků. S kolika jazyky si dokáží poradit velké jazykové modely?
Abychom mohli zkoumat jazykovou vybavenost umělé inteligence, musíme se znovu vrátit k tokenům. V předchozím díle tohoto blogu jsme si tokeny představili. Jazykové modely nepoužívají slova, ale tokeny. Už víme, že token zde není kryptoměna, bezpečnostní sekvence znaků nahrazující PIN nebo dokonce žeton v kasinu. Tokeny jsou sekvence bajtů, na které dekomponujeme text uložený ve formátu UTF-8[2]. Sady tokenů používané velkými jazykovými modely jsou navrženy tak, aby bylo možné tokenizovat text v jakémkoli jazyce a zároveň tak aby reprezentace textu pomocí tokenů byla nejen úsporná, ale i informativní. Výzkum jazykové vybavenosti velkých jazykových modelů začneme popisem procesu tvorby tokenů a také se podíváme na jejich vlastnosti.
Nejpoužívanější algoritmus BPE[3][4] pro přípravu nové sady tokenů si vysvětlíme na konkrétním příkladu. Pro jednoduchost si výrazně snížíme počet znaků na 4. Tím také odpadne problém s komprimací pomocí UTF-8, budeme namísto bajtů pracovat rovnou se znaky.
Naši superkrátkou tréninkovou kolekci tvoří řetězec „aaabdaaabac“ a chceme připravit sadu o sedmi tokenech. Připomeňme si, že velikost výsledné sady tokenů je jediným parametrem algoritmu BPE. Požadovanou velikost sady musíme zvolit před spuštěním BPE.
Do vznikající sady tokenů nejprve vložíme tokeny reprezentující jeden znak a přiřadíme jim celočíselné kódy. Výchozí sada tokenů zapsaná jako slovník v Pythonu má tvar {0:“a“, 1:“b“, 2:“d“, 3:“c“}. Položky ve slovníku jsou odděleny čárkou, každá položka obsahuje kód tokenu a vlastní token. Použijeme-li dosud známé tokeny, můžeme tréninkový řetězec převést na sekvenci kódů tokenů [0, 0, 0, 1, 2, 0, 0, 0, 1, 0, 3]. V této sekvenci spočteme četnosti dvojic sousedních tokenů a vybereme nejčetnější dvojici. Tou je dvojice [0, 0], má četnost 4 a reprezentuje znaky „aa“. Tato dvojice se stane novým tokenem ve slovníku, kde ji přiřadíme další volný kód: {0:“a“, 1:“b“, 2:“d“, 3:“c“, 4:“aa“}. Zatím máme tokenů ve slovníku pouze pět, budeme hledat další četné dvojice.
Znovu tokenizujeme tréninkový text pomocí aktuálního slovníku na sekvenci kódů [4, 0, 1, 2, 4, 0, 1, 0, 3]. Při kódování dostávají přednost delší tokeny, tedy pokud to jde, použijeme jediný token pro znaky „aa“ namísto dvou tokenů pro „a“. Nejčetnější dvojice sousedních tokenů jsou nyní dvě: [0, 1] a [4, 0] s četností 2. Vyberme si třeba první z dvojic reprezentující znaky „ab“. Doplněný slovník nyní čítá šest tokenů: {0:“a“, 1:“b“, 2:“d“, 3:“c“, 4:“aa“, 5:“ab“}. Ještě nám chybí jeden token do plánovaných sedmi, proto znovu projdeme celou smyčku.
Tréninkový text tokenizujeme na sekvenci [4, 5, 2, 4, 5, 0, 3]. Nejvyšší četnost má dvojice [4, 5] odpovídající znakům „aaab“. Přidáním této dvojice do slovníku získáme finální sadu tokenů {0:“a“, 1:“b“, 2:“d“, 3:“c“, 4:“aa“, 5:“ab“, 6:“aaab“}. Tréninkový text by se dal pomocí tohoto slovníku převést na sekvenci [6, 2, 6, 0, 3]. Tuto konečnou sadu bychom dále používali na tokenizaci jakéhokoli textu složeného z písmen „a“, „b“, „c“, „d“.
Pokud výchozí abecedu rozšíříme na celý UNICODE a k uložení do paměti použijeme komprimaci UTF-8, texty budou reprezentovány sekvencemi bajtů s hodnotami od 0 do 255. Výchozí slovník bude mít velikost 256, každý přípustný bajt představuje základní token. Pomocí tréninkové kolekce textů pro BPE bychom slovník rozšiřovali o nejčetnější sousední páry tokenů až do požadované velikosti.
Příklad reálného kódování ukážeme na známé větě z českých slabikářů: „Ema má mísu.“ K zakódování do tokenů použijeme připravenou sadu cl100k_base, kterou používá mimo jiné model GPT-4. Velikost sady, jak napovídá název, je 100 tisíc tokenů. Text se před zakódováním nenormalizuje, tj. žádné znaky se neodstraňují, nezaměňují, nepřidávají a velikost písmen zůstává zachována.
Věta „Ema má mísu.“ obsahuje tři slova a má délku 12 znaků včetně mezer a tečky na konci věty. Na uložení věty pomocí UTF-8 spotřebujeme 14 bajtů: [69, 109, 97, 32, 109, 195, 161, 32, 109, 195, 173, 115, 117, 46]. Pro většinu znaků spotřebujeme jeden bajt, jen písmena s diakritikou spotřebují bajty dva. Konkrétně „á“ se v UTF-8 uloží jako [195, 161] a „í“ jako [195, 173].
Naše jednoduchá věta se pomocí sady cl100k_base zakóduje do sedmi tokenů s celočíselnými identifikátory [36, 1764, 29830, 296, 24315, 84, 13]. Jeden token ve větě v průměru reprezentuje 2 bajty nebo 1,7 znaku. Také můžeme říci, že na jedno slovo připadá v průměru 2,3 tokenu.
Jaké konkrétní tokeny se pro zakódování věty použily? Našich sedm tokenů odpovídá následujícím sedmi sekvencím bajtů: [[69], [109, 97], [32, 109, 195, 161], [32, 109], [195, 173, 115], [117], [46]]. Těchto sedm sekvencí bajtů můžeme po rozkódování pomocí UTF-8 vyjádřit jako sedm krátkých řetězců [‚E‘, ‚ma‘, ‚ má‘, ‚ m‘, ‚ís‘, ‚u‘, ‚.‘][5]. Všimněme si, že tokeny obsahují všechny znaky, včetně mezer a tečky za větou, a proto zpětné složení tokenizované věty je triviální.
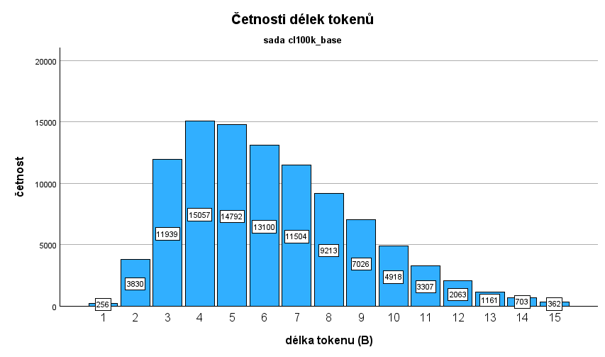
Jak efektivní je zakódování pomocí tokenů a k jak velké redukci informace dochází při přechodu od slov k tokenům? To silně závisí na konkrétním kódovaném textu a na použité sadě tokenů. A to nejen na její velikosti, ale i na textech, ze kterých algoritmus BPE tokeny do zkoumané sady cl100k_base vybíral.
Zkusme pomocí sady cl100k_base nyní zakódovat anglický překlad naší slabikářové věty: „Ema has a bowl.“. Již neuvádím detaily o jednotlivých bajtech, výsledná sada tokenů zapsaných jako sekvence znaků má tvar [‚E‘, ‚ma‘, ‚ has‘, ‚ a‘, ‚ bowl‘, ‚.‘]. Zakódování anglické verze je o jeden bajt úspornější, ačkoli anglický text obsahuje více slov i znaků než česká verze. Z toho plynou i příznivější komprimační poměry. Například jeden token reprezentuje v průměru 2,5 znaku a na jedno slovo připadá 1,5 tokenu.
Předně si ale všimněme, že všechna anglická slova z naší věty jsou ukryta v samostatném tokenu. Pouze české jméno „Ema“ je rozděleno do dvou tokenů. To je zásadní rozdíl oproti zakódování české verze, kde jen jediné slovo „má“ nebylo rozděleno do více tokenů. Ztráta informace při přechodu od slov k tokenům zakódováním pomocí sady cl100k_base je tedy daleko větší pro český text než pro anglický. To klade dodatečné nároky na velký jazykový model, který musí význam textu více rozpoznávat z kontextu tokenů než z tokenů samotných. Je to také jeden z důvodů, proč jazykové modely dávají uspokojivější odpovědi, pokud s nimi konverzujeme anglicky[6].
Podíváme-li se blíže na tokeny ze sady cl100k_base, zjistíme, že připomínají anglický slovník. Sada samozřejmě začíná jednobajtovými základními tokeny. Pak následují tokeny pro krátké frekventované sekvence znaků, které připomínají anglické předložky a přípony. Když procházíme sadu dále, pozorujeme delší tokeny reprezentující fragmenty anglických slov a pak i celá anglická slova. I mezi tokeny s velmi vysokými kódy budou stále převládat anglické výrazy, i když zde už občas narazíme na token připomínající cizí jazyk.
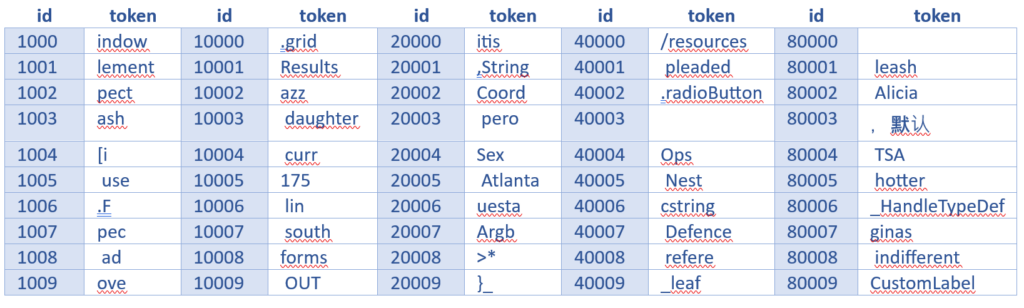
Složení sady cl100k_base jednoznačně poukazuje na fakt, že při sestavování sady algoritmus BPE používal v drtivé většině anglické texty. Proto zakódování anglického textu sadou cl100k_base bude efektivnější a výsledné tokeny ponesou vyšší informaci než při zakódování cizojazyčných textů. A tak můžeme s nadsázkou říci, že jazykové modely nejlépe rozumí anglickému textu. Za to, že dokáží velmi obstojně komunikovat i v jiných jazycích, vděčí své schopnosti pracovat s kontextem. Nutnou podmínkou pro konverzování v jiném jazyce je pak učení modelu na cizojazyčných dokumentech[7].
Ať už vybereme jakýkoli algoritmus pro získání tokenů a při hledání tokenů použijeme jakoukoli kolekci dokumentů, každý jazykový model umí pracovat jen se svou sadou tokenů. Sada tokenů jazykového modelu determinuje i jeho vnitřní architekturu. Jazykový model nezpracovává slova z některého z přirozených jazyků, ale tokeny ze své sady. Otázku z úvodu článku o jazykové vybavenosti umělé inteligence bychom měli přeformulovat na otázku: S kolika sadami tokenů umí jazykový model pracovat? Odpověď je prostá: Každý jazykový model pracuje právě s jednou sadou tokenů.
Z minulého dílu víme, že používané sady čítají desítky až stovky tisíc tokenů. Také už víme, že sady tokenů jsou navrženy tak, abychom do tokenů dokázali rozdělit text zapsaný v libovolném jazyce, dokonce bez ohledu na to, jaké používá písmo. Ačkoli jazykový model zná jen tu svou jedinou sadu tokenů, dokáže pomocí ní přečíst jakýkoli text. Na proces tokenizace se můžeme dívat jako na překlad dokumentu tvořeného slovy některého přirozeného jazyka do jazyka tokenů, kterému velký jazykový model rozumí. Znalost přirozených jazyků se tak transformuje do porozumění obsahu tokenizovaného textu. Porozumění obsahu a odpověď modelu závisí na tom, co si velký jazykový model zapamatoval při svém strojovém učení. To také probíhalo tak, že se učební texty nejprve tokenizovaly, aby je modely dokázaly využít. Pokud byly při strojovém učení předkládány modelu i české dokumenty, model chápe, co se ukrývá v sekvenci tokenů reprezentujících český text, a také bude schopen odpovědět sekvencí tokenů, z které na výstupu složíme českou odpověď.
Jazykové modely mohou fungovat i jako překladatelé mezi přirozenými jazyky. Nemusí se jednat jen o speciální jazykové modely učené nad dvojjazyčnými kolekcemi dokumentů. O překlad stačí běžný jazykový model požádat v promptu. Jazykový model chápe požadavek na překlad spíše jako úlohu na přeformulování, protože používá svou jedinou sadu tokenů. Překlad funguje tak, že překládaná věta se převede do řeči velkého jazykového modelu, do tokenů. Model ze sekvence tokenů pochopí význam věty a záměrně odpoví ve své řeči tokenů stejnou větou přeformulovanou takovým způsobem, aby se odpověď dala dekódovat do cílového přirozeného jazyka.
Jak to bude vypadat, když jazykový model bude vést dialog s jiným jazykovým modelem? Pokud oba hovoří stejnou řečí, tj. používají stejnou sadu tokenů, odpadá potřeba dekódovat tokeny na znaky. Sekvenci tokenů z výstupu jednoho modelu můžeme rovnou vložit na vstup druhého modelu. Pokud však modely hovoří jinými jazyky, tj. používají různé sady tokenů, potřebují tlumočníka. Tlumočníkem mezi modely se přirozeně stane dekodér tokenů spolu s tokenizátorem. Tlumočníky budeme potřebovat dva, jeden tlumočník bude překládat tokeny prvního modelu do tokenů druhého modelu a druhý tlumočník zase naopak. Určitě by bylo zajímavé sledovat, do jakých přirozených jazyků by se tokeny při dialogu dvou modelů dekódovaly. Možná by to souviselo s probíranými tématy nebo s aktuální náladou umělé inteligence.
[1] Velký počet z nich však nemá písemnou podobu.
[2] UTF = Unicode Transformation Format
[3] BPE = Byte Pair Encoding
[4] BPE není jediným algoritmem. Pro některé sady tokenů se používají jeho modifikace jako jsou Unigram, WordPiece nebo SentencePiece. Existují též postupy pro vyřazování tokenů z příliš velké sady.
[5] Zde máme štěstí, že všechny použité tokeny lze převést na sekvence znaků. Token je sekvence bajtů a nemusí začínat a končit na stejné pozici, kde v UTF-8 začíná či končí znak.
[6] Silně to též ovlivňují texty poskytnuté pro učení velkého jazykového modelu.
[7] Nezaměňujme učení velkého jazykového modelu s hledáním tokenů algoritmem BPE. Učení velkého jazykového modelu spočívá v nastavování jeho skrytých parametrů a je výpočetně mnohem náročnější.
Máte recenze od svých zákazníků, otevřené odpovědi z dotazníků,
přepisy telefonních hovorů nebo jiné textové záznamy
a chtěli byste je analyzovat?
Právě tady přichází na řadu Text Analytics.
Využijte konzultace s odborníkem zdarma.