Bez kvalitních dat ani AI nefunguje: datová kvalita v praxi
Datová kvalita nejčastěji charakterizuje stav dat z pohledu úplnosti, shody, konzistence, aktuálnosti, unikátnosti, integrity a přesnosti. Tento stav se snažíme popsat pomocí pravidel na základě kterých vytváříme různé souhrnné metriky. Interně si pak určíme, jakých hodnot mají tyto metriky nabývat, a co už bude nepřípustné, a tedy považováno za nekvalitní data, která musí být očištěna.
Abychom však nějaká data mohli označit za (ne)kvalitní, musíme je znát. A to je často větší problém, než se zdá. Data jsou často roztříštěna na různých místech a formátech, pojmenována „lidsky nepochopitelnými“ technickými názvy, někdy i v různých jazycích a často vznikají „historicky používanými procesy“ o kterých už mnohokrát nikdo neví, co vlastně provádějí. Ale díkybohu fungují, a tak se na ně nesahá. Je nutno si ale uvědomit, že takováto data jsou pro AI naprosto nepoužitelná. Aby AI data mohla využít, musí být velice dobře popsána a zdokumentována. AI potřebuje znát kontext.
Prvním krokem pro zajištění datové kvality a následné využití kvalitních dat v AI, tedy je poznat a popsat data významově i obsahově, provést datový audit, určit datové vlastníky, garanty a stewardy (lidi, kteří mohou provádět případné úpravy dat). Dále je nutné poznat a zkontrolovat procesy, které data vytváří a zpracovávají. Poté je nutné vytvořit, formalizovat a automatizovat pravidla, kterými data budeme popisovat a na základě kterých vytvoříme metriky, které budou datovou kvalitu určovat. Následně je nutné určit maximální míru nekvality, která vyvolá eskalační opravné procesy. Ty je potřeba samozřejmě také definovat – je nutné určit kdo, kdy, jak a čím problém vyřeší.
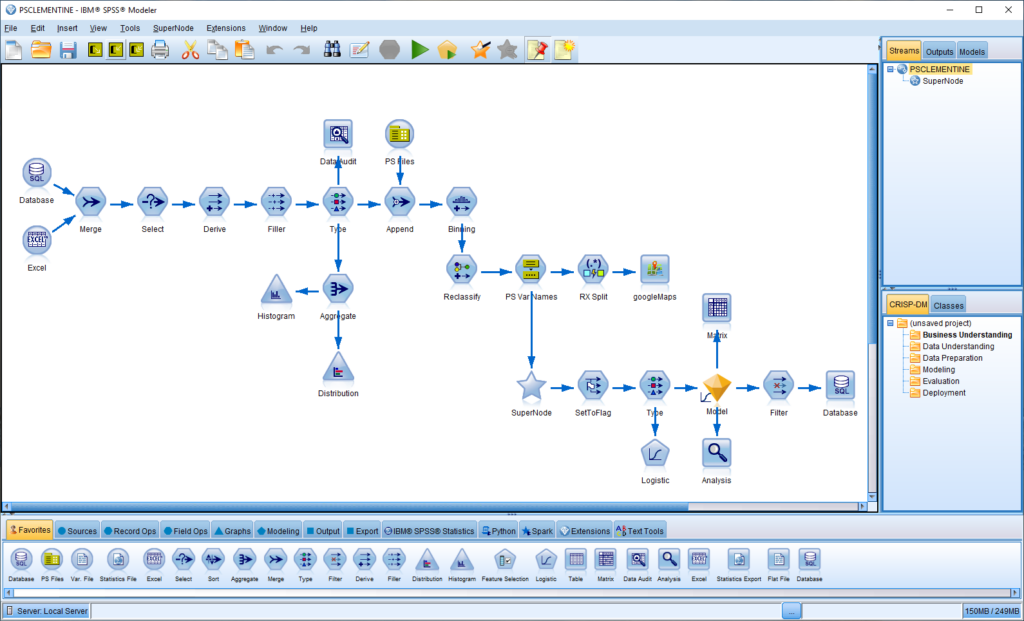
Protože se pořád hovoří o datech, potřebujeme k tomu nějaké prostředky, nástroje, kterými data můžeme načíst, připravit, transformovat, agregovat a různě s nimi manipulovat. Všechny datové úkony je třeba zaznamenat a automatizovat. K tomu můžeme použít programovací opensource nástroje, interní nástroje datového úložiště, pro úlohu datové kvality specializované nástroje nebo obecnější dataminingové nástroje. Já osobně dávám přednost grafickým, uživatelsky přívětivým, dataminingovým nástrojům, protože předem nevím, s čím se setkám a co budu potřebovat. Tyto nástroje jsou schopné datového auditu, záznamu a automatizace procesů, řešení datových adhoc úloh, a hlavně naprosto klíčové explorace dat.
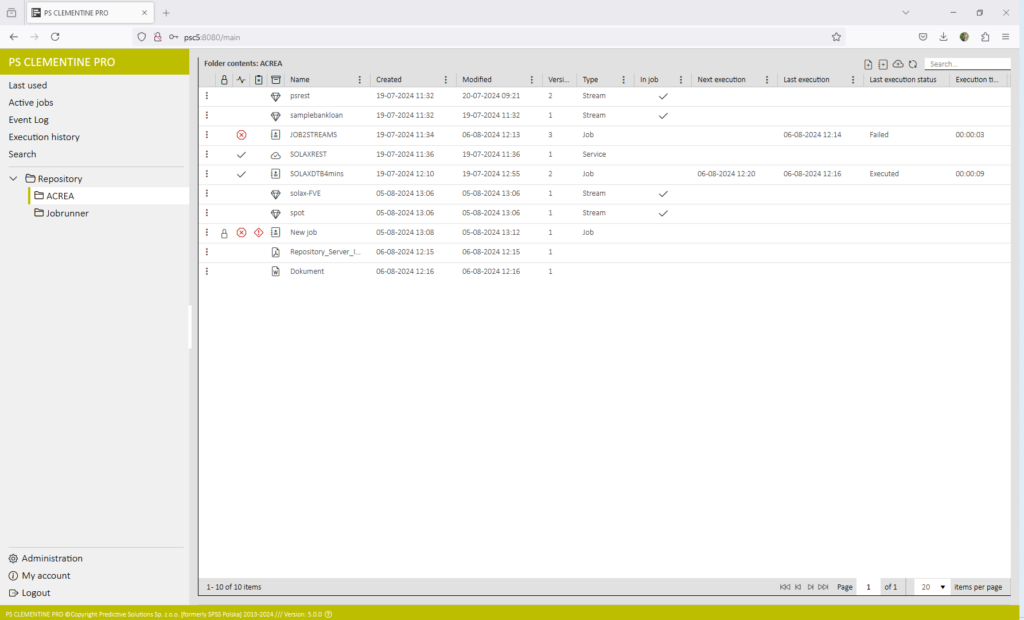
V rámci datové kvality nestačí pouze definovat pravidla a ukázat na chyby. Chyby je potřeba jednoduše a přehledně odreportovat a následně nechat řešit kompetentními vlastníky/stewardy. Pro jejich řešení je nutné poznat příčiny a k tomu se zase dá využít dataminingový nástroj pro hlubší vhled do dat a vztahů mezi nimi.
Dosažení datové kvality v praxi tak představuje velkou výzvu, a to z pohledu organizačního, procesního, administrativní a datově exploračního. Velice důležité je přesvědčit všechny v organizaci, od vedení po standardní uživatele, že datová kvalita je důležitá (to si všichni uvědomují), ale že je třeba na ní aktivně dohlížet a kontinuálně ji naplňovat. Důležité je začít, projít si počátečními těžkostmi s neznámými daty a neochotou některých zúčastněných. Primární investice, časová i peněžní je velká, ale kvalitní data povedou ke správnějším rozhodnutím včetně využití obrovského potenciálu AI.
Ztrácíte čas i peníze kvůli nepřesným datům, chybám v reportech nebo nespolehlivým výstupům pro AI?
Pomůžeme vám odhalit skryté nedostatky, vyčistit datové toky
a nastavit udržitelný systém řízení datové kvality (Data Governance).
Sjednejte si bezplatnou konzultaci s naším odborníkem a získejte spolehlivá data,
na která se můžete při rozhodování plně spolehnout.